
Le scraping connecté de LinkedIn viole les conditions d’utilisation de la plateforme et peut exposer un compte à un bannissement. En France, les données publiques restent quand même soumises au RGPD depuis le 25 mai 2018, donc la vraie question n’est pas “peut-on scraper”, mais “quel risque on prend et par quoi on remplace”.
Le discours le plus populaire sur le web scraping LinkedIn est trompeur, parce qu’il mélange vitesse d’exécution, accès à la donnée et droit d’usage. En pratique, aspirer des profils depuis un compte connecté vous met dans la zone la plus fragile, et même les données visibles publiquement ne deviennent pas “libres” pour autant. La CNIL rappelle que la publication n’efface pas la base légale nécessaire à toute réutilisation, ce qui change complètement la façon de penser la prospection B2B en France, surtout quand les signaux collectés identifient des personnes physiques.
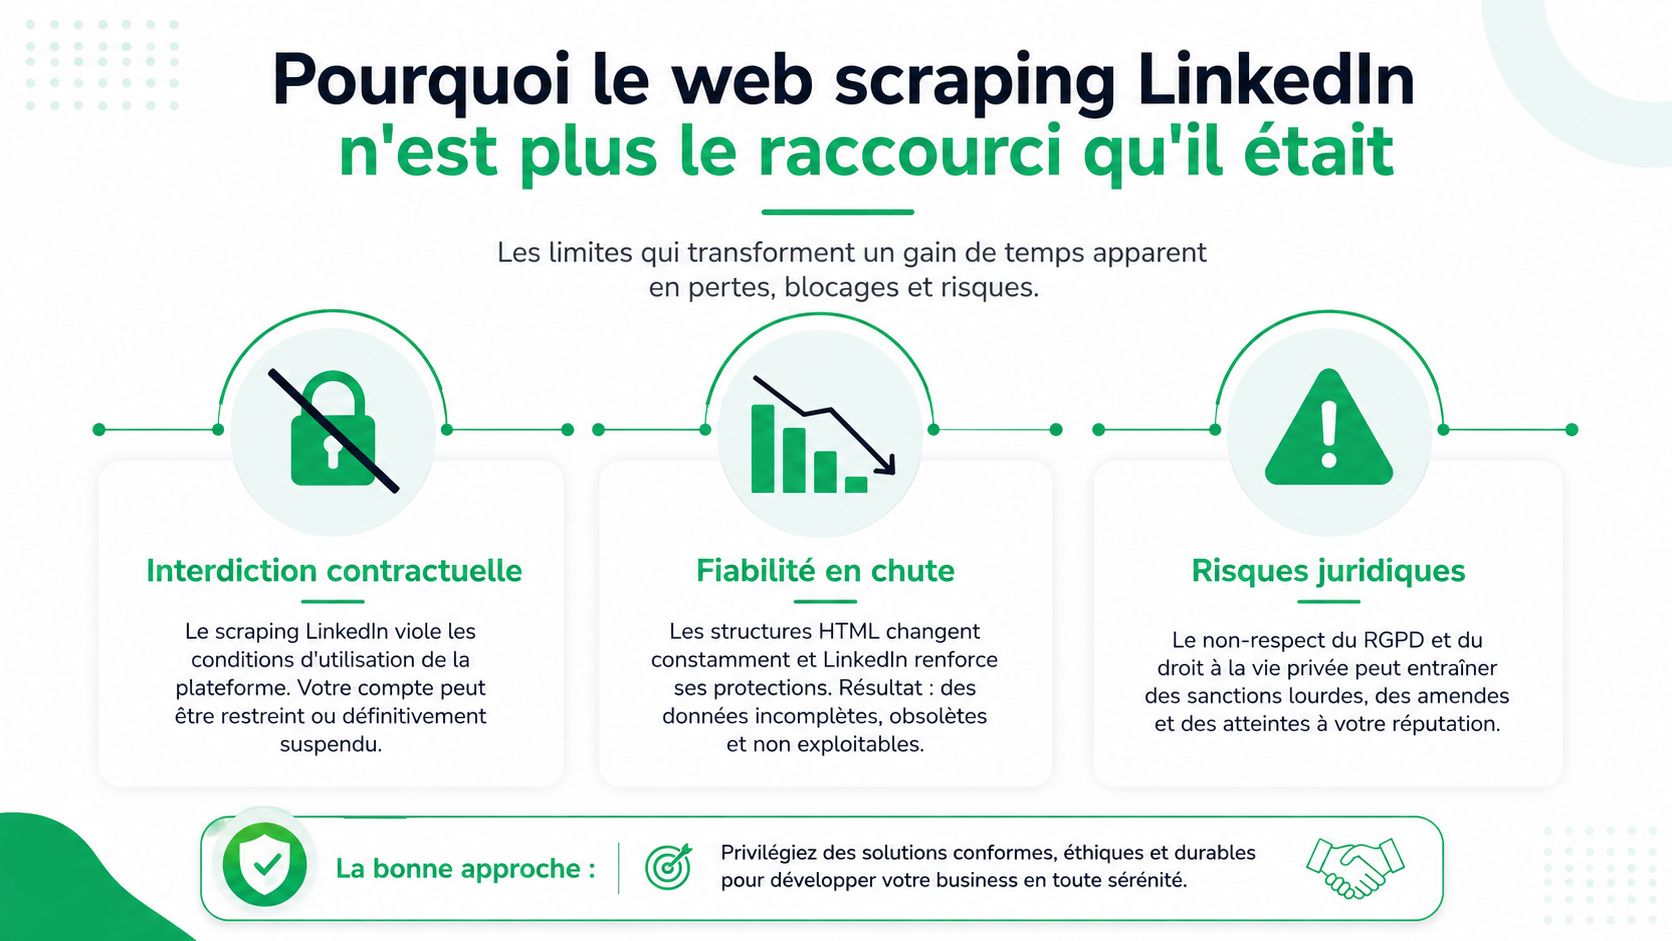
Table des matières
-
Pourquoi le web scraping LinkedIn n’est plus le raccourci qu’il était
-
Comment fonctionne techniquement un pipeline de scraping LinkedIn
-
Les risques réels d’un scraping LinkedIn pour une équipe B2B française
-
Scraping, API, Sales Navigator ou signaux d’intention, que choisir en 2026
-
Feuille de route pour passer d’un stack scraping à un stack signaux
-
Ce qu’il faut arrêter, garder et mettre en place dès cette semaine
Pourquoi le web scraping LinkedIn n’est plus le raccourci qu’il était
Le mythe du scraping “gratuit et illimité” ne tient plus. LinkedIn interdit explicitement les logiciels tiers qui automatisent, scrappent ou modifient le site, y compris ceux qui envoient des invitations, des likes, des messages ou extraient des données, et la plateforme l’assume clairement dans ses règles d’usage sur les risques de scraping. Le lien utile à garder sous la main, c’est aussi celui qui rappelle les limites pratiques de LinkedIn pour les équipes commerciales en France, les limites de LinkedIn pour la prospection.
La mauvaise habitude, chez beaucoup d’équipes, consiste à regarder seulement la donnée obtenue. C’est une erreur. Une donnée LinkedIn aspirée dans un contexte connecté porte trois charges en même temps, la charge contractuelle, la charge technique, et la charge juridique, et c’est cette addition qui rend le sujet explosif en France.
Règle pratique, si l’outil a besoin de votre session connectée pour fonctionner, vous n’achetez pas seulement de la donnée, vous achetez aussi un risque de compte.
Le fantasme et la réalité
| Aspect | Fantasme | Réalité 2026 en France |
|---|---|---|
| Accès | Donnée rapide et massive | Accès souvent fragile, surtout en connecté |
| Conformité | “Public donc réutilisable” | Le public reste encadré par le RGPD |
| Fiabilité | Pipeline stable | Détection, limitation et casse fréquente |
| Valeur business | Liste de prospects prête à l’emploi | Signaux parfois utiles, mais coûteux à maintenir |
| Risque | Faible si on “reste discret” | Risque contractuel, juridique et réputationnel |
Dans cette logique, le bon arbitrage n’est plus “scraper ou ne pas scraper”, mais “quelles données méritent vraiment d’être capturées”. Plus le pipeline dépend d’un compte connecté, plus vous augmentez l’exposition du dirigeant, du compte vendeur et de la marque. C’est là que beaucoup de projets B2B se trompent, ils maximisent l’extraction et minimisent la gouvernance.
Comment fonctionne techniquement un pipeline de scraping LinkedIn
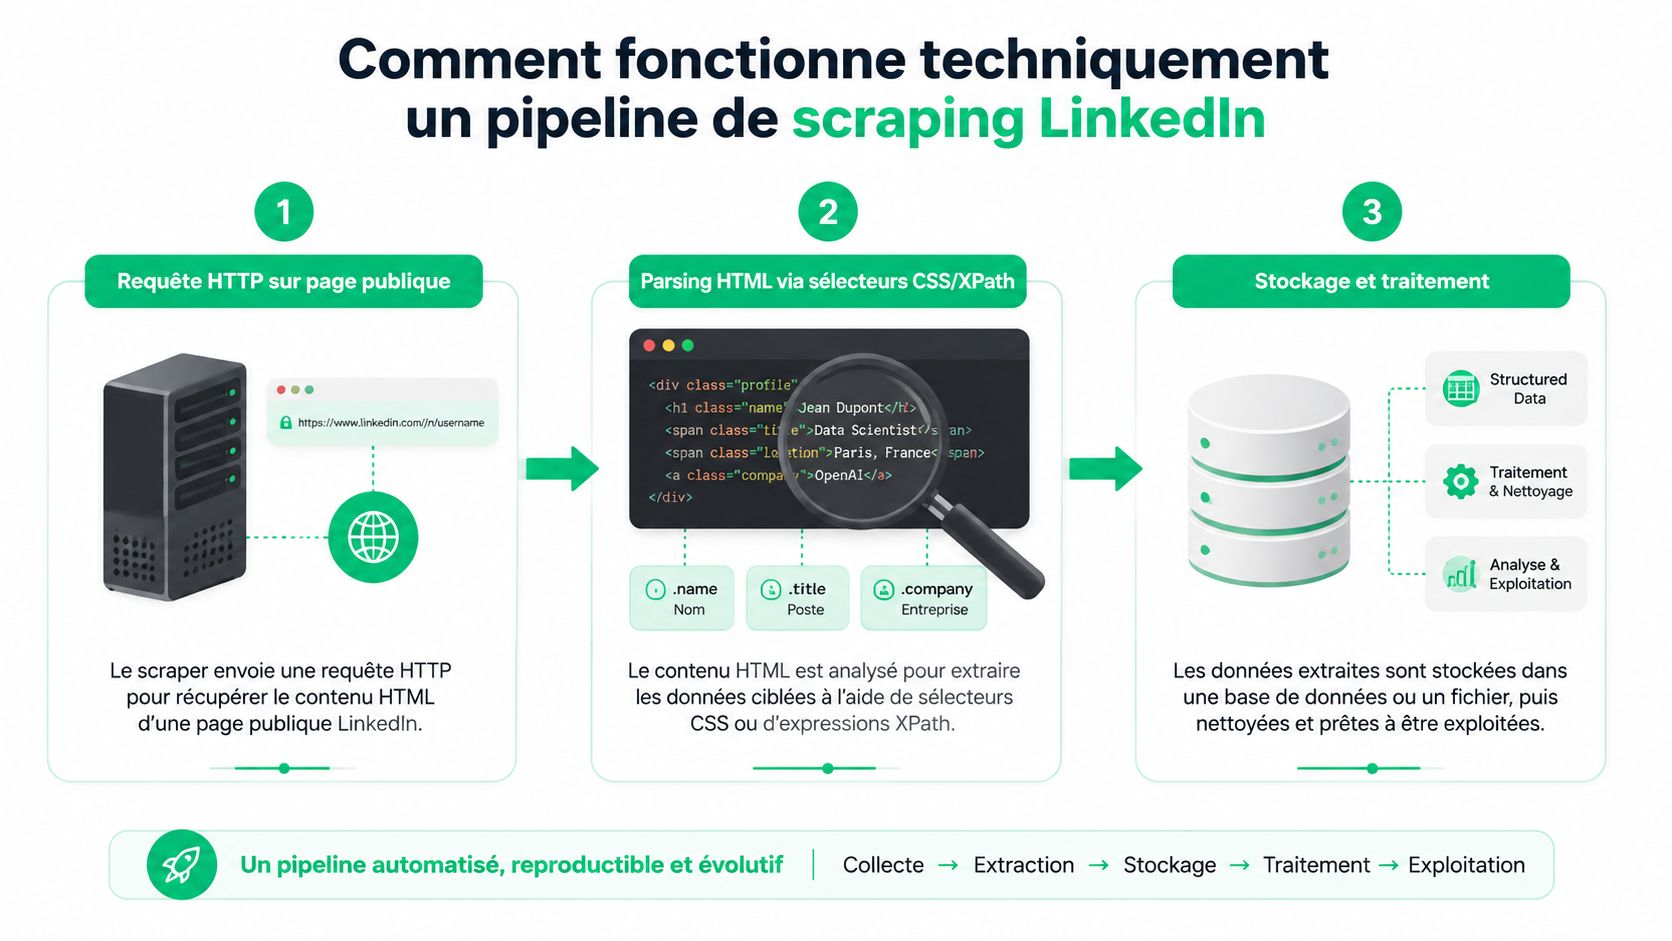
Le pipeline classique repose sur trois briques. D’abord, une requête HTTP sur une page publique, ensuite le parsing HTML pour extraire ce qui est lisible dans le code, puis l’exploitation du JSON embarqué dans certaines balises <script> quand la page expose des données structurées. Les guides techniques décrivent ce flux comme la manière la plus simple de réduire le recours à l’automatisation lourde, donc de limiter la surface de détection.
Ce que font les outils sérieux
Les implémentations plus avancées ajoutent des proxys résidentiels rotatifs, des délais aléatoires et la rotation des user-agents pour simuler un trafic moins mécanique. Techniquement, ça peut améliorer la tenue du pipeline, mais ça ne règle ni la question de fond sur les CGU, ni celle de la qualité des signaux capturés.
La différence clé se joue entre scraping public et automatisation connectée. Le premier reste plus défendable sur le plan technique, parce qu’il évite la session utilisateur et les interactions à haut risque. Le second ressemble à un agent qui agit à votre place depuis votre compte, donc il concentre à la fois les risques de détection et les risques d’usage abusif.
Une équipe commerciale doit mesurer la fragilité d’un scraper au même titre qu’elle mesure la délivrabilité d’une séquence email, sinon elle confond vitesse de départ et stabilité réelle.
Ce qu’il faut lire dans un outil avant de l’acheter
- Source de la donnée.Si l’outil exige un login, considérez qu’il porte un risque supérieur.
- Type d’extraction.Le parsing de HTML public n’a pas le même profil qu’une automation navigateur.
- Traitement des échecs.Un bon outil dit ce qu’il fait quand une page change, bloque ou ralentit.
- Sortie exploitable.Une liste brute ne vaut pas un signal qualifié.
- Traçabilité.Sans journal d’exécution, vous ne savez pas ce que le système a vraiment fait.
Le point clé est simple. Plus le scraping dépend d’un processus connecté, moins il ressemble à une infrastructure de données et plus il ressemble à une prise de risque opérationnel. C’est précisément pour ça que les équipes sérieuses commencent à sortir du réflexe “tout scraper” et à regarder ce qu’elles peuvent remplacer par des flux mieux gouvernés.
Les risques réels d’un scraping LinkedIn pour une équipe B2B française
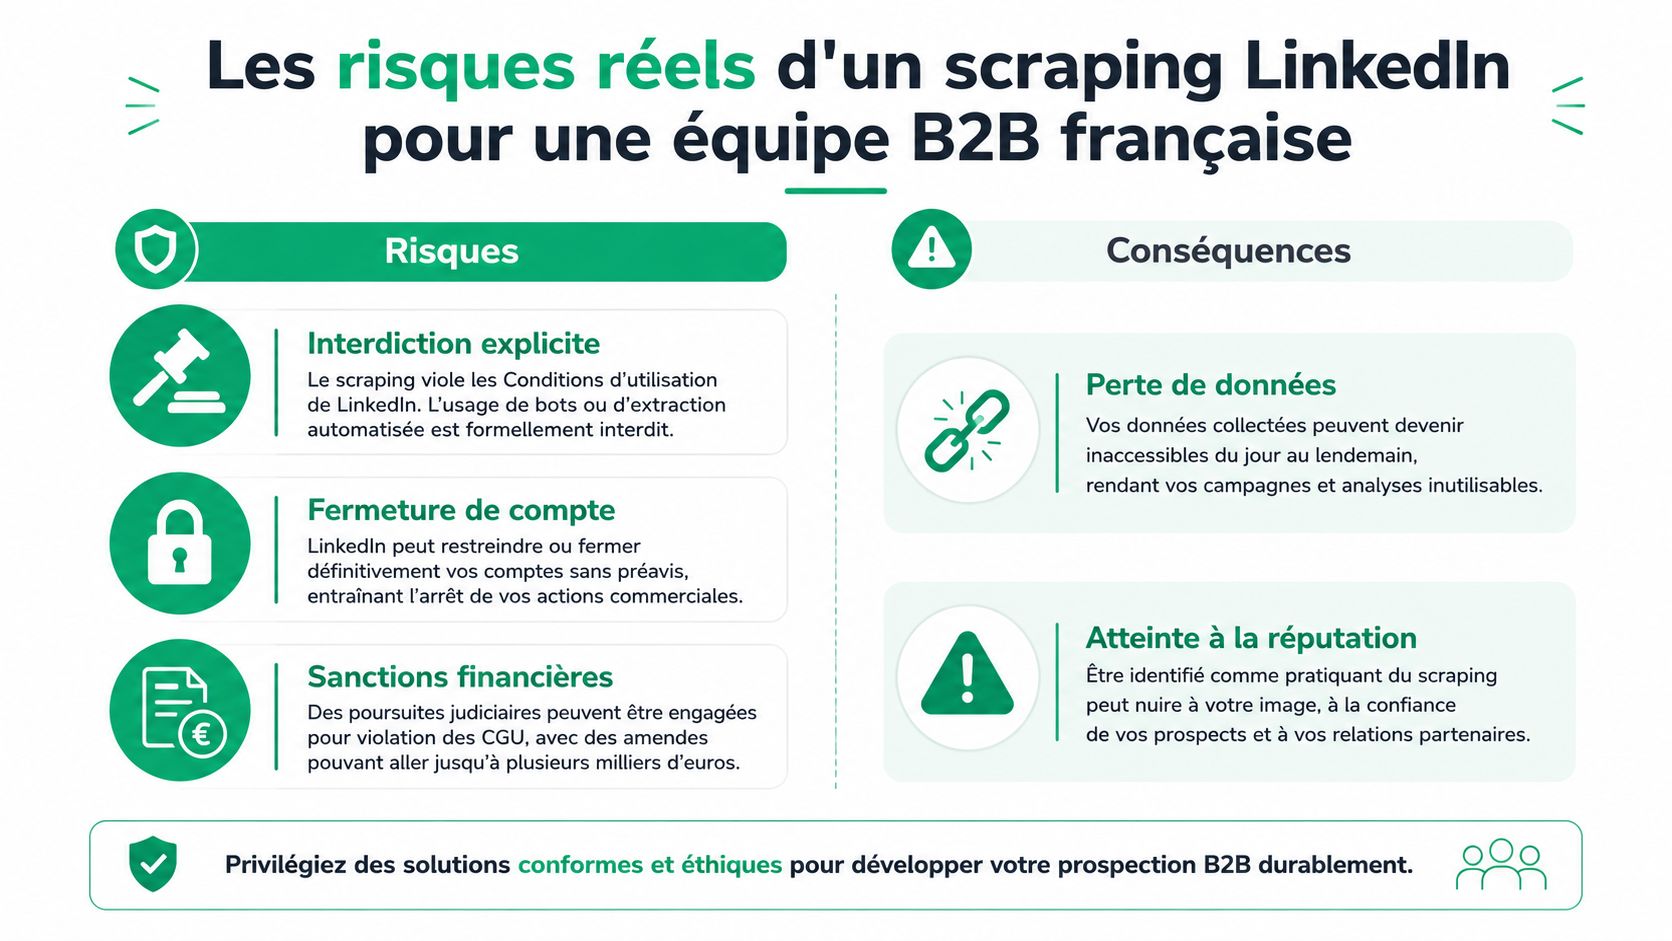
Le premier risque est contractuel. LinkedIn interdit les outils tiers qui automatisent ou extraient des données depuis la plateforme, et dès qu’un projet repose sur un compte connecté, il sort du terrain confortable. Pour une équipe française, ce n’est pas un détail technique, c’est un risque direct sur la continuité commerciale et sur le compte lui-même.
Le deuxième risque, c’est le RGPD. Le règlement s’applique depuis le 25 mai 2018, et il couvre toute donnée personnelle, y compris des informations professionnelles visibles sur LinkedIn quand elles permettent d’identifier une personne. La CNIL rappelle aussi qu’une donnée publique ne devient pas réutilisable sans base légale. L’argument “c’est public” ne tient pas.
Ce que les équipes sous-estiment le plus
Le coût caché est opérationnel autant que juridique. Quand un scraper casse, l’équipe perd du temps à réparer, relancer, reparser, puis requalifier des données qui ont déjà perdu en fraîcheur. Cette maintenance permanente grignote la marge des agences, ralentit les SDR, et fatigue les fondateurs qui pensaient avoir industrialisé leur acquisition.
La réputation entre aussi dans l’équation. Si un prospect comprend que ses données ont été aspirées sans cadre clair, la conversation commerciale démarre mal. Dans une relation B2B française, ce signal pèse souvent plus lourd qu’un blocage technique isolé.
LinkedIn a aussi publié des contenus de mise en garde sur les risques liés au scraping de données, ce qui montre bien que la plateforme ne traite pas ce sujet comme un simple détail de développement. Et même si le débat public a beaucoup tourné autour de la jurisprudence américaine type hiQ vs LinkedIn, une équipe française doit raisonner avec son propre cadre de conformité, car le terrain juridique n’est pas le même.
Ce qu’il faut lire dans un outil avant de l’acheter
- Source de la donnée.Si l’outil exige un login, considérez qu’il porte un risque supérieur.
- Type d’extraction.Privilégiez les outils qui extraient via HTML public plutôt que via un compte connecté, car le premier ne lie pas le scraper à votre identité LinkedIn.
- Traitement des échecs.Un bon outil dit ce qu’il fait quand une page change, bloque ou ralentit.
- Sortie exploitable.Une liste brute ne vaut pas un signal qualifié.
- Traçabilité.Sans journal d’exécution, vous ne savez pas ce que le système a vraiment fait.
Le point clé est simple. Plus le scraping dépend d’un processus connecté, moins il ressemble à une infrastructure de données et plus il ressemble à une prise de risque opérationnel. C’est aussi là qu’un achat de comptes LinkedIn pour la prospection devient une fausse bonne idée, parce qu’il ajoute un risque de gouvernance à un risque déjà élevé.
Scraping, API, Sales Navigator ou signaux d’intention, que choisir en 2026
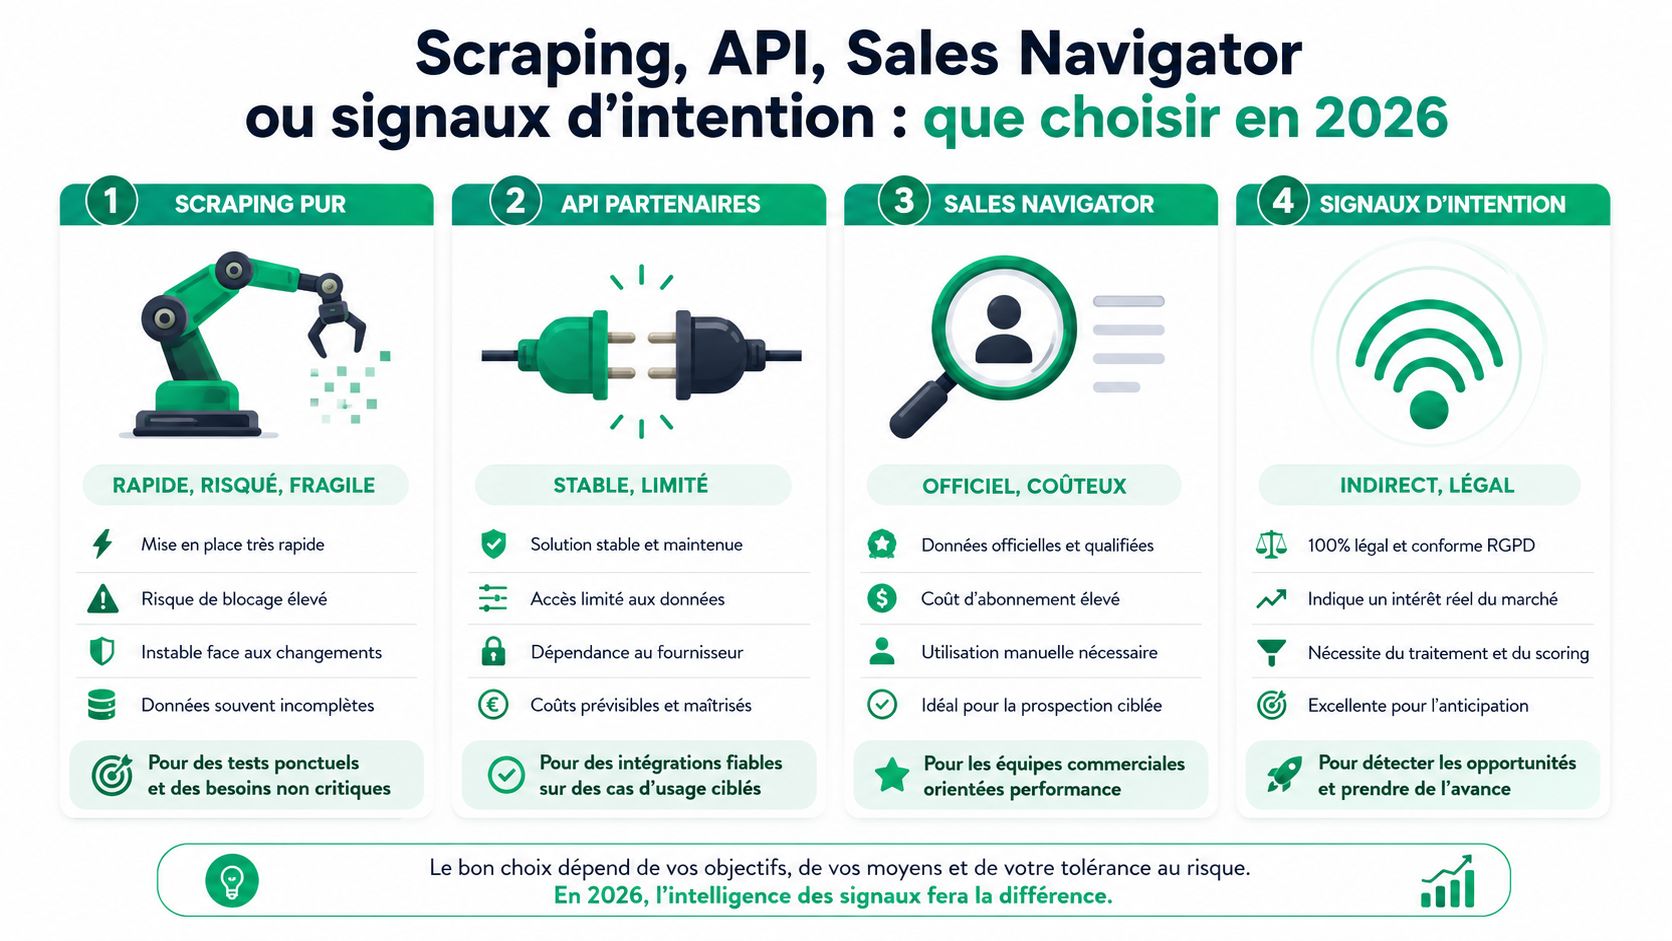
Le bon choix dépend moins de la fascination pour la donnée que de votre tolérance au risque. Le scraping pur reste rapide à lancer, mais il est fragile. Les API partenaires et les exports sont plus stables, mais ils couvrent moins de cas d’usage. Sales Navigator donne un cadre officiel pour la recherche, mais ce n’est pas un passe-droit pour aspirer LinkedIn.
Comparaison utile, sans poudre aux yeux
| Méthode | Conformité CGU LinkedIn | Risque RGPD en France | Fiabilité 2026 | Profil recommandé |
|---|---|---|---|---|
| Scraping pur | Faible | Élevé si données personnelles réutilisées sans base claire | Fragile | Éviter pour la prospection connectée |
| API partenaires | Meilleure | Plus maîtrisable | Plus stable | Équipes data et ops |
| Sales Navigator | Officiel | À cadrer selon l’usage | Stable pour la recherche | SDR, fondateurs, agences |
| Signaux d’intention | Compatible si bien gouverné | Plus défendable | Très exploitable | Équipes commerciales orientées conversion |
Le vrai basculement, en 2026, vient des signaux d’intention. Une visite de profil, un like, un commentaire pertinent, une invitation acceptée ou une réponse donnent souvent plus de valeur commerciale qu’une fiche brute mal maintenue. Ils racontent ce qui se passe maintenant, pas seulement qui existe dans la base.
- **
Verdict par profil
- Agence.Gardez la recherche, abandonnez la capture massive de fiches. Votre marge dépend de votre vitesse de réaction, pas d’une montagne de profils.
- SDR.Privilégiez les signaux actionnables, vous gagnerez en priorisation et en qualité de relance.
- Fondateur solo.Choisissez ce qui vous évite de maintenir un scraper à la main.
- Growth.Visez la traçabilité, pas le volume brut, sinon vos automatisations deviennent impossibles à expliquer.
Le constat est dur, mais clair. Pour la prospection B2B française, les signaux d’intention prennent l’avantage sur le scraping de fiches, parce qu’ils se branchent mieux sur le cycle de vente et se défendent mieux dans une logique de conformité.
Yadulink comme alternative conforme au scraping pur
Le changement utile n’est pas de remplacer un scraper par un autre scraper. C’est de passer d’une logique d’aspiration à une logique de détection de signaux. Une plateforme comme Yadulink capte des événements LinkedIn traçables, comme les visites de profil, les likes, les commentaires, les invitations acceptées et les réponses, puis déclenche une action adaptée selon le signal reçu.
Ce modèle répond à un problème très concret. Au lieu d’empiler des fiches, vous travaillez sur des interactions réelles, ce qui facilite la priorisation commerciale et la justification RGPD. Le fait de centraliser les interactions, de qualifier les signaux, et d’arrêter les séquences dès qu’il y a réponse change complètement la manière d’exécuter la prospection.
Ce que l’équipe voit vraiment
Les équipes qui travaillent proprement veulent trois choses, la traçabilité, la réversibilité, et la priorité. Un tableau de bord qui suit les invitations, les acceptations, les réponses, les signaux captés et les actions déclenchées apporte justement cette lecture pipeline. C’est aussi pour ça que la messagerie intégrée, les étiquettes et l’assistance IA comptent davantage que la quantité brute de profils.
La logique de ciblage reste importante, mais elle ne repose plus sur un scrape massif. Vous pouvez importer des profils issus d’événements, de recherches, d’interactions de posts, de groupes, d’abonnés ou de pages entreprise, puis déclencher des séquences multi-étapes qui s’arrêtent automatiquement à la réponse. C’est plus simple à gouverner et plus facile à expliquer à un dirigeant.
Si votre équipe passe plus de temps à réparer l’outil qu’à gérer les conversations, le problème n’est pas la prospection, c’est le modèle de collecte.
La réversibilité compte aussi. Yadulink propose un essai gratuit de 7 jours, puis une offre Pro unique à 79 €/mois, avec des intégrations MCP pour Claude et ChatGPT, et une feuille de route qui va vers l’API, les webhooks, n8n, Zapier et Make. Le lien utile à garder est les données d’intention LinkedIn, parce qu’il replace le sujet sur la valeur du signal plutôt que sur la mécanique du scraping.
Feuille de route pour passer d’un stack scraping à un stack signaux
Un audit sans complaisance est la première étape. Listez chaque source LinkedIn utilisée, chaque compte impliqué, chaque export et chaque automatisation, puis marquez ce qui dépend d’un login connecté. Vous verrez vite où se concentre le risque, et ce qui n’apporte qu’une illusion d’efficacité.
La suite consiste à classer les signaux par valeur réelle. Une visite de profil cible, un like sur un post stratégique, un commentaire pertinent, une acceptation d’invitation ou une réponse à un message n’ont pas le même poids, mais ils ont un point commun, ils se transmettent sans extraire une fiche complète. C’est ce qui permet de construire un stack plus propre, plus lisible, et surtout plus défendable.
Un plan simple à exécuter
- Cartographiez les flux actuels.Identifiez ce qui alimente le CRM, ce qui alimente les séquences, et ce qui ne sert à rien.
- Coupez les dépendances inutiles.Tout ce qui exige un compte connecté sans gain clair doit sortir en premier.
- Définissez vos signaux prioritaires.Visez les interactions qui montrent un intérêt réel, pas les profils les plus simples à aspirer.
- Mettez en place la qualification.Un même signal ne doit pas déclencher la même réponse selon le segment.
- Construisez des séquences qui s’arrêtent à la réponse.C’est la règle de base pour éviter l’automatisation aveugle.
- Créez un tableau de bord pipeline.Suivez invitations, acceptations, réponses, signaux et actions déclenchées au même endroit.
- Branchez les intégrations par étapes.Commencez par MCP, puis reliez n8n, Zapier ou Make quand le process tient la route.
- Documentez la base légale et la conservation.Sans cette couche, le stack reste bancal, même s’il paraît propre sur le plan technique.
Le livrable utile n’est pas une pile d’outils, c’est un système que l’équipe peut expliquer sans improviser. Si vos SDR savent dire pourquoi un compte a été contacté, quel signal a déclenché l’action, et à quel moment la séquence s’est arrêtée, vous avez déjà changé de catégorie. Vous passez d’une logique d’aspiration à une logique de décision.
Ce qu’il faut arrêter, garder et mettre en place dès cette semaine
- Les trois changements à opérer cette semaine sont simplesarrêter le scraping connecté et l’automatisation de masse, garder seulement la recherche via Sales Navigator et les exports officiels, puis mettre en place une capture de signaux d’intention reliée à un tableau de bord pipeline.
Le point de départ est clair. Tout enrichissement qui dépend d’un compte connecté sans base légale documentée doit sortir du stack. Le web scraping LinkedIn public reste, au mieux, un usage ponctuel et strictement cadré, pas un moteur de prospection.
Ensuite, installez une séquence qui réagit au comportement réel du prospect. Une invitation acceptée, une réponse, une visite répétée, un engagement sur un contenu, voilà les déclencheurs qui comptent. Les campagnes de masse continuent d’épuiser les équipes et d’abîmer la lisibilité du pipeline.
Les trois indicateurs à suivre
- À 30 jours,comparez le taux de réponse des séquences fondées sur des signaux à celui de vos campagnes de masse.
- À 60 jours,mesurez le nombre de signaux captés par compte SDR et par segment.
- À 90 jours,regardez la part du pipeline attribuable aux signaux d’intention plutôt qu’aux listes froides.
Ce cadrage évite les faux débats. La question n’est plus de savoir comment aspirer davantage de profils, mais quels signaux méritent une action commerciale et quels outils respectent ce cadre.
Le verdict est net. Le web scraping LinkedIn connecté n’est plus un raccourci, c’est un pari risqué pour votre équipe, votre compte et votre dirigeant. Si vous voulez une prospection B2B qui tienne en France, remplacez le réflexe d’aspiration par une logique de signaux, d’API et d’outils conformes.
Yadulink aide les équipes B2B à capter les signaux LinkedIn utiles, à les qualifier, puis à lancer des séquences qui s’arrêtent quand le prospect répond. Si vous voulez remplacer un stack de scraping fragile par un système plus traçable et plus simple à gouverner, allez voir Yadulink et testez comment vos signaux peuvent devenir des conversations.